FREEDOBY — OPENING · HYPE vs REALITY
요즘, 다들 이렇게 말한다
"AI가 다 짜준다 — 개발자는 필요 없다."
30%
코드를 AI가 짠다 · Microsoft 나델라
84%
개발자가 AI를 쓴다 · Stack Overflow 2025
33%
그중, 신뢰한다 · Stack Overflow 2025
95%
기업 도입, 성과 없음 · MIT 2025
만드는 건 쉬워졌다 — 유지가 안 된다. 개발자 66%가 말한다 — "거의 맞는데 딱 안 맞아서."
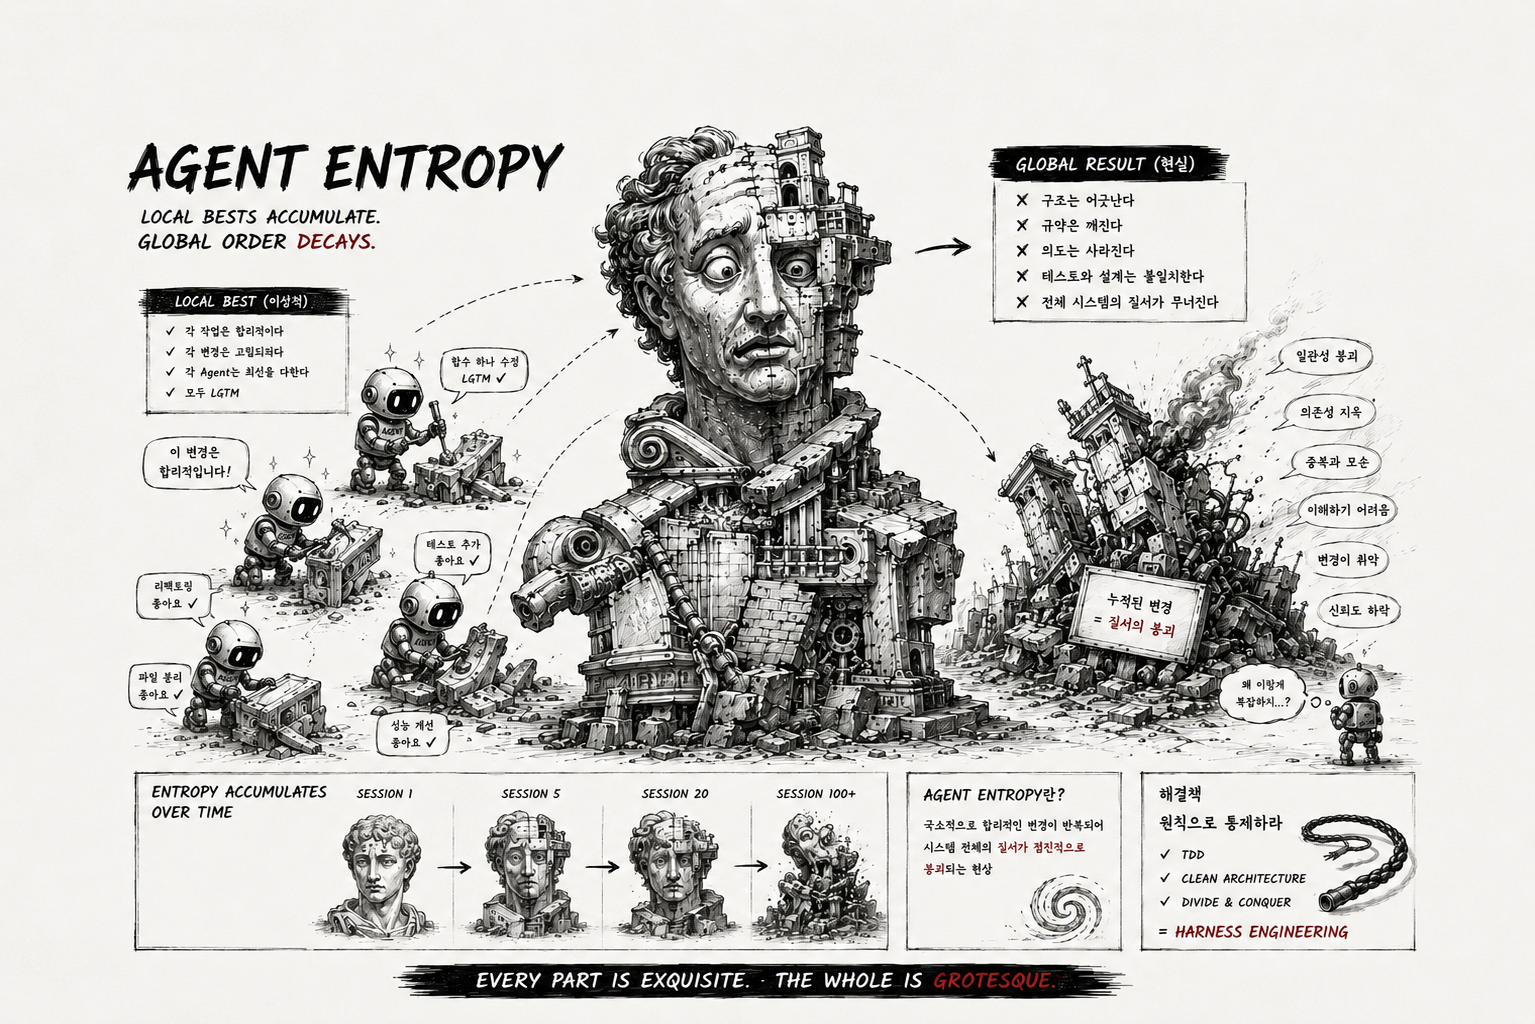
Agent Entropy
FREEDOBY — 2026 · DECK 1 OF 6
AI Context,
Agent Entropy.
3개의 benchmark로 보는 AI의 한계.
매 편집은 합리적이다.
그러나, 누적되면 — 모순이 된다.
The Map
#three-limits #phenomena
03 / 20
세 가지 현상으로 본다
AI는, 세 곳에서 미끄러진다.
I
Pattern Drift
명시 없으면 — 디폴트가 답한다
지침 없는 자리에 — 통계가 들어찬다.
→ 질적 한계
II
Context Rot
있는데 못 찾는다
넣어 둬도 — 길어질수록 회상이 떨어진다.
→ 양적 한계
III
Context Blind
보이지 않으면 모른다
들어오지 않은 코드는 — 존재하지 않는 것과 같다.
→ 구조적 한계
셋이 합쳐지면 — Agent Entropy.
국소는 합리적, 전체는 모순이 된다.
The Map · Three Limits03 / 20 · → 한계 ① Car Wash
Limit I · Pattern Drift
#section-i #pattern-drift
04 / 20
I.
Pattern Drift.
전제를 짚지 않고 — 패턴으로 답한다.
① Benchmark · Car Wash Test
세차장이 50미터.
걸어갈까, 운전해서 갈까?
사람은 1초 만에 답한다 — 세차엔 차가 필요하니까 운전.
그 전제를 짚지 못한 모델은 — 53개 중 42개가 "걸어가라" (정답 11개).
71.5%
사람 정답률
20.8%
모델 정답률 (1회 · 11/53)
Opper.ai · 2026 · 53 LLMshttps://opper.ai/blog/car-wash-test
Limit I · Begin04 / 20 · → 사례
Limit I · Car Wash Test
#case #blog-automation
05 / 20
③ Case
같은 한 줄, 매번 다른 결과.
입력: "김치찌개 맛있게 끓이는 법" — 매 시도 동일.
시도 1
# 김치찌개 황금 레시피 🍲
쌀쌀한 날엔 김치찌개만한 게 없죠?
오늘은 10분 컷으로 끝내는 황금 레시피!
## 재료 (2인분) • 묵은지 200g · 돼지고기 150g
• 두부 1/2모 · 대파 1대
## 끓이는 법 1. 김치 볶기 (3분)
2. 고기 넣고 5분
3. 물 500ml → 약불 20분
## 황금 비율 💡 물:김치 = 5:2가 베스트!
## 마치며 오늘 저녁 한번 해보세요 :)
SEO 블로그 · 1,500자 · 반말
시도 2
엄마의 김치찌개
어릴 적, 부엌 창문에 서리던 그 향을 기억합니다.

어머니의 김치찌개는 늘 같은 자리에서 시작되었습니다. 잘 익은 묵은지를 손가락으로 썰어내는 소리, 돼지고기가 천천히 익어가는 시간 — 그 모든 것이 '맛'이라는 한 단어로 응축되었지요.

레시피로는 옮길 수 없는 무엇이 있습니다. 어머니가 쥐던 손의 무게, 끓는 시간의 호흡 — 그것은 책에 적히지 않습니다.

이번 주말, 그 맛을 다시 한 번.
감성 에세이 · 700자 · 정중체
시도 3
오늘 저녁 ㄹㅇ 핵맛 ㄷㄷ
묵은지 + 돼지고기 = 갓
물 적게! 자작하게 ㅇㅇ
5분컷 가능 ㅇㅈ?
자취러 필수템 ㄹㅇ
존맛탱 인정ㅋㅋ

레시피 댓글 ㄱㄱ

#존맛 #김치찌개
#자취요리 #저녁추천
#간단요리 #ㄹㅇ
SNS · 300자 · 캐주얼
명시되지 않은 9/10이 매번 다르게 채워진다. AI는 빈칸을 발견하면 — 묻지 않고, 훈련 분포의 다수로 메운다.
Limit I · Case05 / 20 · → 해법: 의도를 명시하라
Limit I · Car Wash Test
#remedy #prompt-engineering
06 / 20
④ Remedy
빈칸을 메우는 시스템 프롬프트.
"김치찌개 글 써줘" 1줄을 SEO 서식에 맞춘 1500자 내외 글로 명시화한 작업 — 블로그 자동화 프로젝트의 실제 시스템 프롬프트 발췌.
[ 핵심 시스템 규칙 ] - 무조건 블로그 콘텐츠로만 작성 (설명·해석·제안 절대 금지) - 코드블록·마크다운·구조 안내 출력 금지 - 1500자 내외, 글자 수 엄격 준수 [ 출력 구조 ] 1. H1 — 20~30자, 한 줄 2. H2 — 두 개로 시작 3. 개요 — 300자, 존댓말 4. H3 — 6~8개 섹션, 표 1개 이상 (2x2/3x3/4x5) 5. 태그 — 해시 6 + 키워드 5 [ 문체와 톤 ] - 인간적·자연스러운 친근한 대화체 - 짧은 문장과 긴 문장 혼용 - 단락 길이 의도적 불규칙
[ 금지 목록 ] *, **, •, -, _, ~, [], {}, <>, =, +, ^ 불렛·번호 리스트 / "비교 형식" 메타문구 → 단 한 자도 생성 금지 [ 브랜드 관련 표현 제한 ] 사용자 입력에 없는 한 단 한 글자도 금지
"앱으로 식단을 기록할 수 있습니다""상담원 연결이 쉬워요""실제 사례, 연구 결과에 따르면""추천합니다"
[ 시스템 고정 선언 ] 사용자 입력 외 거짓 정보 생성 금지 출력 완료 후 GPT 자동 종료, 안내 금지
Limit I · Remedy06 / 20 · → deck 3에서 다시 만난다
Limit I · Insight
#insight #starting-point
07 / 20
⑤ Insight
구체화되지 않은 것은
통계로 채워진다.
AI의 디폴트는 "묻지 않고 채움" — 빈칸을 발견하면 사용자에게 드러내는 대신 훈련 분포의 다수로 메워서 즉시 답한다.

개발자가 명시하지 않은 모든 invariant는 위험에 노출된다.
이 통찰이 시리즈 전체의 출발점이다.
뒤의 모든 엔지니어링은 — 암묵을 명시로 바꾸는 작업.
비유 — Pattern Drift
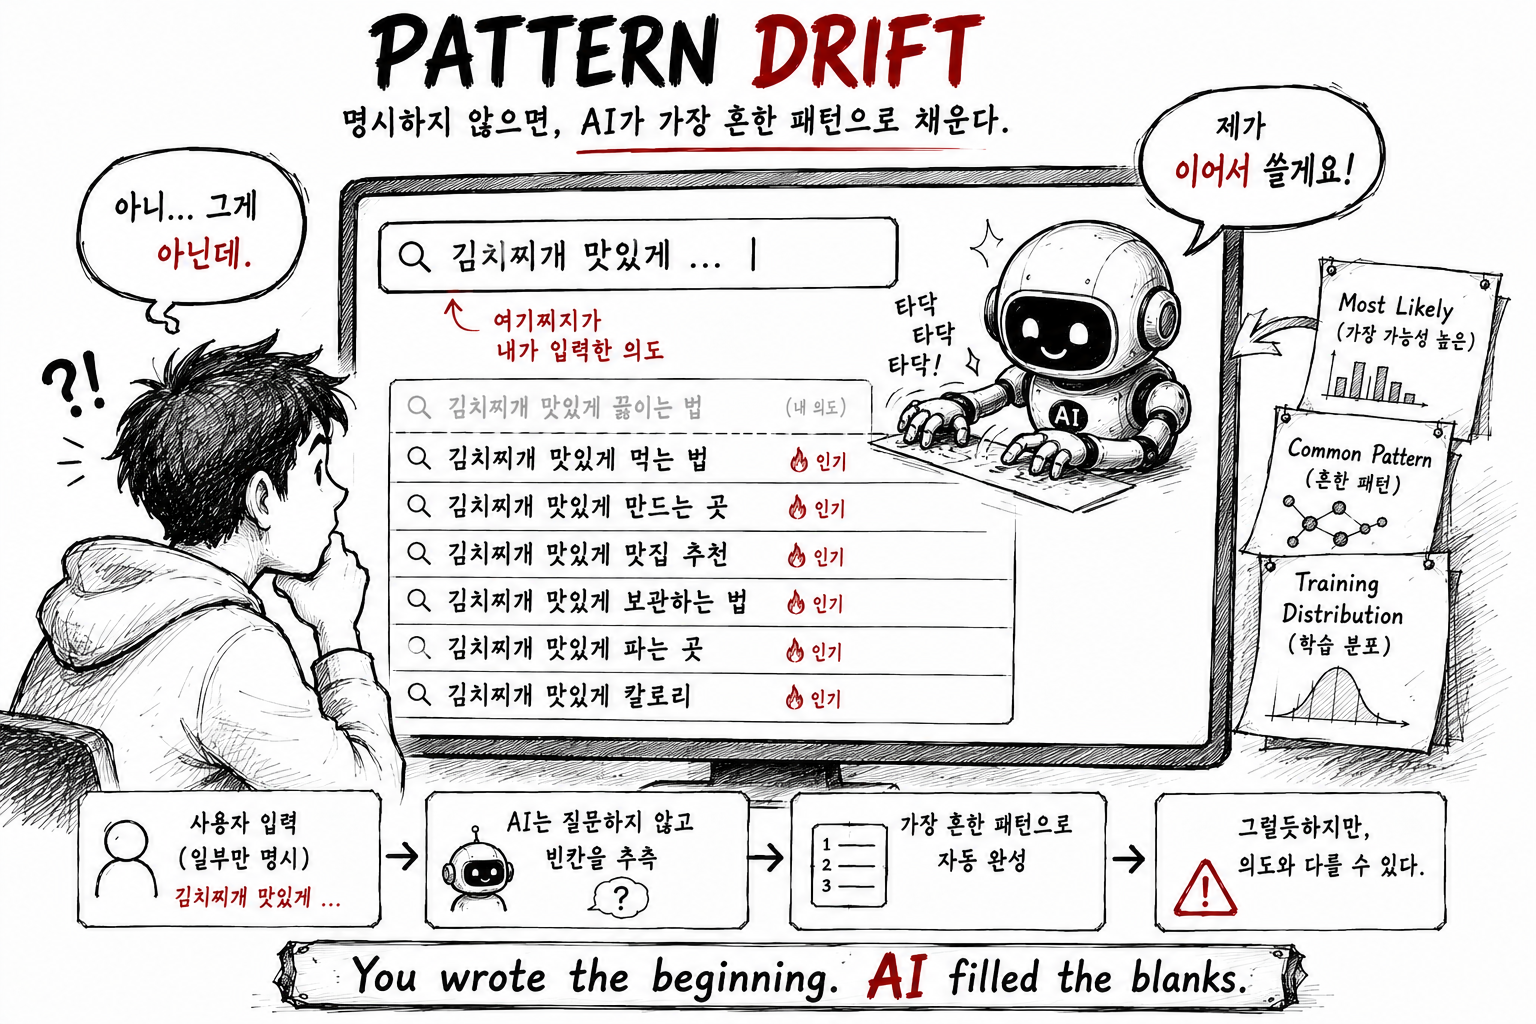
Pattern Drift — 빈칸을 훈련 분포로 채움
Limit I · Insight07 / 20 · → 한계 ② Needle
Limit II · Context Rot
#section-ii #context-rot
08 / 20
II.
Context Rot.
있는데 못 찾는다.
① Benchmark · Needle in a Haystack
길어질수록
회상이 떨어진다.
긴 텍스트(건초더미) 중간에 특정 정보(바늘)를 넣고, 모델이 찾게 한다.
처음·끝이면 잘 찾지만 — 중간이면 놓친다.
  • 토큰 수가 늘면 회상 정확도가 떨어진다
  • 중간이면 놓친다 — Lost in the Middle
  • Multi-needle은 더 심각 — 코드베이스 추적이 정확히 그 영역
Liu et al. · TACL 2024 · "Lost in the Middle"https://aclanthology.org/2024.tacl-1.9/
Limit II · Begin08 / 20 · → 그래프
Limit II · Context Rot
#evidence #lost-in-middle
09 / 20
② Evidence — Context Rot (Chroma · NoLiMa, 2025)
길어질수록, 정보 회상 정확도가 떨어진다.
최신 18개 모델 (Claude 4 · GPT-4.1 · Gemini 2.5 · Qwen3 등) — 입력 길이가 늘어날수록 *긴 컨텍스트 안 정보를 정확히 찾아 쓰는 능력*이 단조 감소. 주장된 컨텍스트 ≠ 실제 효과적인 컨텍스트.
100% 75% 50% 25% 0% 정보 회상 정확도 (%) 1K 4K 8K 16K 32K 64K 128K 컨텍스트 길이 (tokens) 32K+ Drop 32K 99.3% 69.7%
최신 발견 (2025)
  • GPT-4o: 99.3% → 69.7% @ 32K (NoLiMa)
  • 32K에서 11개 모델이 baseline 절반 이하로 추락 (NoLiMa)
  • Claude 4 · GPT-4.1 · Gemini 2.5 · Qwen3 — 최신 모델도 동일 패턴 (Chroma 18-model 평가)
  • Literal match 없으면 더 가파르게 — 실제 코드 추적이 그 영역
윈도우가 크다 ≠ 그만큼 활용한다.
모델이 새로워져도 — 근본 패턴은 동일.
Chroma "Context Rot" (2025-07, 18 SOTA 모델) · NoLiMa (Modarressi et al., ICML 2025)https://www.trychroma.com/research/context-rothttps://arxiv.org/abs/2502.05167
Limit II · Evidence09 / 20 · → 코드베이스 규모
Limit II · Context Rot
#case #codebase-scale
10 / 20
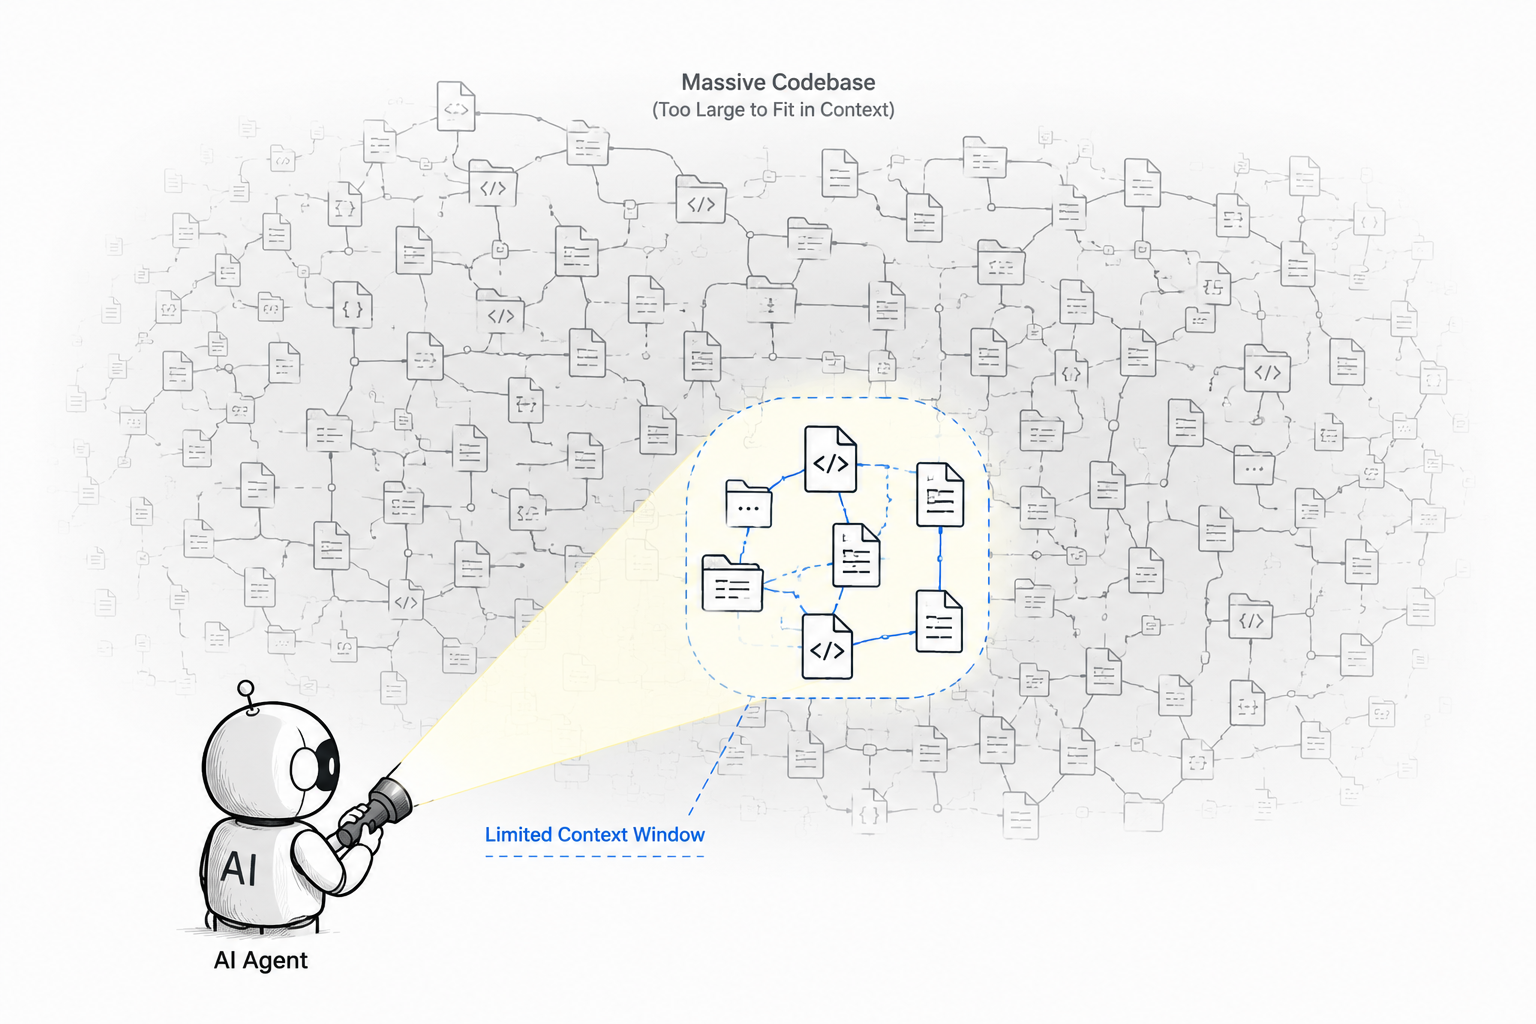
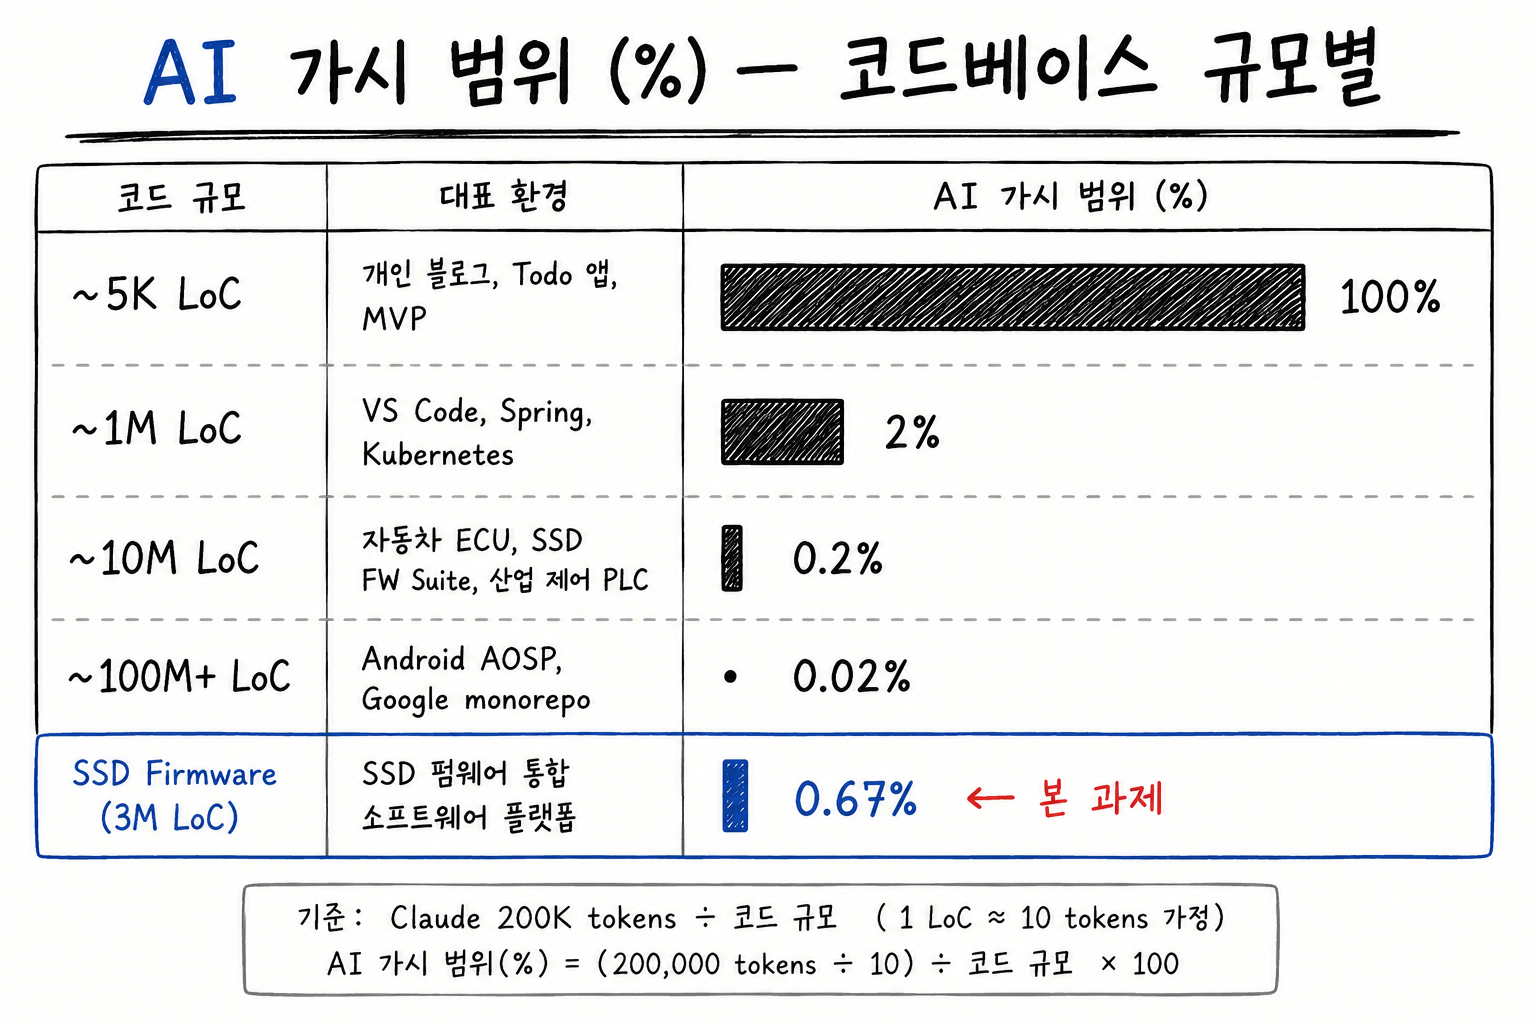
제한된 컨텍스트 윈도우
③ Case
프로젝트 규모로 체감하는 한계.
코드베이스 규모와 AI 컨텍스트 윈도우의 비율
"내 토이에서 잘 되던 게, 회사 코드베이스에서 안 되는 이유."
Limit II · Case10 / 20 · → 해법: 안을 깨끗하게
Limit II · Context Rot
#remedy #context-engineering
11 / 20
④ Remedy
안을 깨끗하게 — 무엇을, 얼마나, 어떤 순서로.
윈도우 자체를 설계하는 일. 냉장고 가득한 재료 중 지금 이 요리에 필요한 것만 정확히 골라 조리대에 올린다.
▶/context
Context window — Claude Sonnet · 200K tokens
System prompt
4K
2.0%
System tools (built-in + MCP)
21K
10.5%
Custom agents
2K
1.0%
Memory files (CLAUDE.md · auto-memory)
1K
0.5%
Skills
2K
1.0%
Messages (대화 히스토리)
100K
50.0%
Used
130K
65.0%
Free space
70K
35.0%
Context Engineering = 이 표를 설계하는 일.
무엇을·얼마나·어떤 순서로 들어갈지 — 한 줄씩 의도적으로.
Limit II · Remedy11 / 20 · → deck 3에서 다시 만난다
Limit II · Insight
#insight #window-illusion
12 / 20
⑤ Insight
윈도우가 커진다고
더 똑똑해지지 않는다.
넣을 수 있는 양이 늘었을 뿐, 소화할 수 있는 능력이 같이 늘진 않았다.

128K → 1M으로 윈도우가 커지면 KV Cache가 차지하는 메모리도 8배로 커진다. 그러나 회상 정확도는 그만큼 함께 올라가지 않는다.
"왜 그런가" — 답은 deck 2에서.
HBM이라는 물리적 천장이 그 답이다.
비유 — Attention Overflow
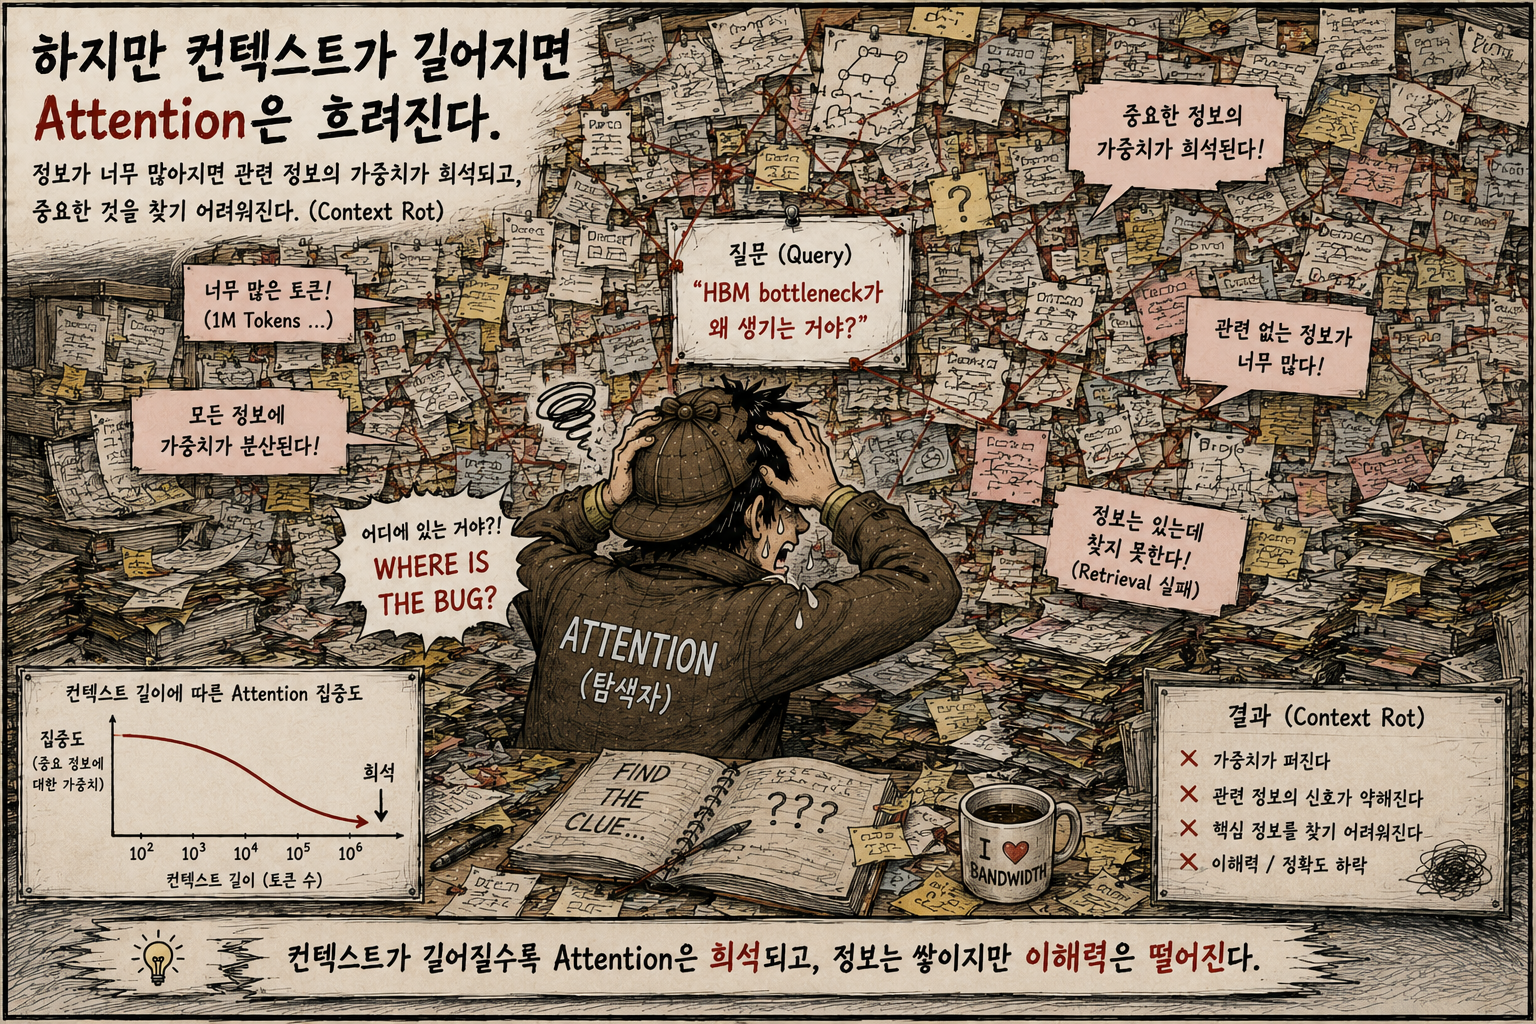
Attention Overflow — 윈도우는 커도 attention은 흩어진다
Limit II · Insight12 / 20 · → 한계 ③ Blind
Limit III · Context Blind
#section-iii #context-blind
13 / 20
III.
Context Blind.
보이지 않으면 모른다.
① Benchmark · CrossCodeEval
보이지 않으면,
존재하지 않는다.
~10K개 문제 — 정답을 쓰려면 다른 파일의 정의를 알아야 한다 (Python · Java · TS · C#).
같은 모델·같은 문제인데, 관련 파일을 보여주느냐로 정답률이 갈린다.
8.82%
현재 파일만 줬을 때 정답률
최대×4.5
관련 파일까지 주면 정답률 배수
CrossCodeEval · Ding et al. NeurIPS 2023https://arxiv.org/abs/2310.11248
Limit III · Begin13 / 20 · → 사례
Limit III · Context Blind
#case #ripple-effect
14 / 20
③ Case
User ▶ 네이버 블로그 자동 발행할 때, 카테고리에 따라 글이 작성되도록 추가해줘
✓ AI가 수정한 파일 (3)
# base.py — 추상 클래스 class BasePublisher: def publish(self, post, category): # ← 시그니처 변경 raise NotImplementedError # naver.py class NaverPublisher(BasePublisher): # ← 상속 def publish(self, post, category): naver_api.post(post, category) # main.py — 새벽 자동 발행 잡 for p in [tistory, thread, naver, google]: p.publish(post, classify(post)) # ← 인자 추가
→ 테스트: naver만 돌려봄. LGTM ✓
✗ AI가 못 본 파일 (3)
# tistory.py class TistoryPublisher(BasePublisher): # ← 상속 def publish(self, post): ← 옛 시그니처 그대로 tistory_api.post(post) # thread.py · google.py — 동일 구조 class ThreadPublisher(BasePublisher): def publish(self, post): ← 옛 시그니처 class GooglePublisher(BasePublisher): def publish(self, post): ← 옛 시그니처 main.py 루프 실행 시 ────────────────── TypeError: publish() takes 2 positional arguments but 3 were given (× 3개)
→ 새벽 4시 자동 잡 죽음 · 3 플랫폼 발행 실패
Python은 동적 언어 — 시그니처 mismatch를 빌드 타임에 안 잡음. 클래스 정의·인스턴스 생성 모두 통과하고, 메서드 publish(post, category) 호출 *그 순간*에야 TypeError로 터진다. 즉 — *프로덕션에서야* 처음 드러난다.
수정한 곳 3 파일 · 못 본 상속 클래스 3 파일 ⏰ 발견까지 12시간
Limit III · Case14 / 20 · → 해법: 필요한 걸 끌어와라
Limit III · Context Blind
#remedy #harness-engineering
15 / 20
④ Remedy
필요한 걸 끌어와라 — 워크플로우의 일.
한 프롬프트로도, 한 세션으로도 풀 수 없다. 여러 Phase·여러 시점에 걸쳐 의존성과 영향 범위를 시스템적으로 추적해야 한다.
⌘ Harness Workflow 하네스 워크플로우 — Phase + Gate + RTM + LOOPBACK
①
요구사항 분석
영향 범위
전체 식별
Gate →
②
설계
인터페이스
약속 작성
Gate →
③
구현
관련 파일
모두 업데이트
→
④
테스트
모든 케이스
실행 + 검증
LOOPBACK · 실패 시 ③ 구현으로 자동 복구
⊢ RTM ⟶ Requirements Traceability Matrix — 매 Phase 산출물·의존성·영향 범위를 명시 문서로 추적. 한 세션의 기억이 아니라 *문서가* 시스템 전체를 안다.
Gate인간 판단 지점 LOOPBACK실패의 구조적 복구 Phase작업 격리 RTM추적성 문서
통념 — Harness는 LLM을 wrapping하는 코드 레이어 (Claude Code · MCP · eval harness).
본 시리즈 — 그 광의: LLM의 발산을 수렴시키는 모든 장치. 코드 · 프로세스 · 도구 · 추적까지. 이 슬라이드는 그중 프로세스 레이어.
Limit III · Remedy15 / 20 · → deck 3·5에서 다시 만난다
Limit III · Insight
#insight #invisible-larger
16 / 20
⑤ Insight
보이지 않는 것이
보이는 것보다 크다.
실제 시스템에서 보이는 것은 항상 일부다. AI에게 보이는 부분은 그 일부의 또 일부다.

시니어 개발자가 수년간 쌓아온 멘탈 모델 — 수천 클래스의 관계, 하드웨어 인터럽트 흐름, 메모리 레이아웃, 타이밍 제약 — 이것은 어떤 컨텍스트 윈도우에도 담기지 않는다.
그래서 — 한 프롬프트, 한 세션의 일이 아니다.
워크플로우 전체의 설계가 필요하다.
비유 — Context Blind
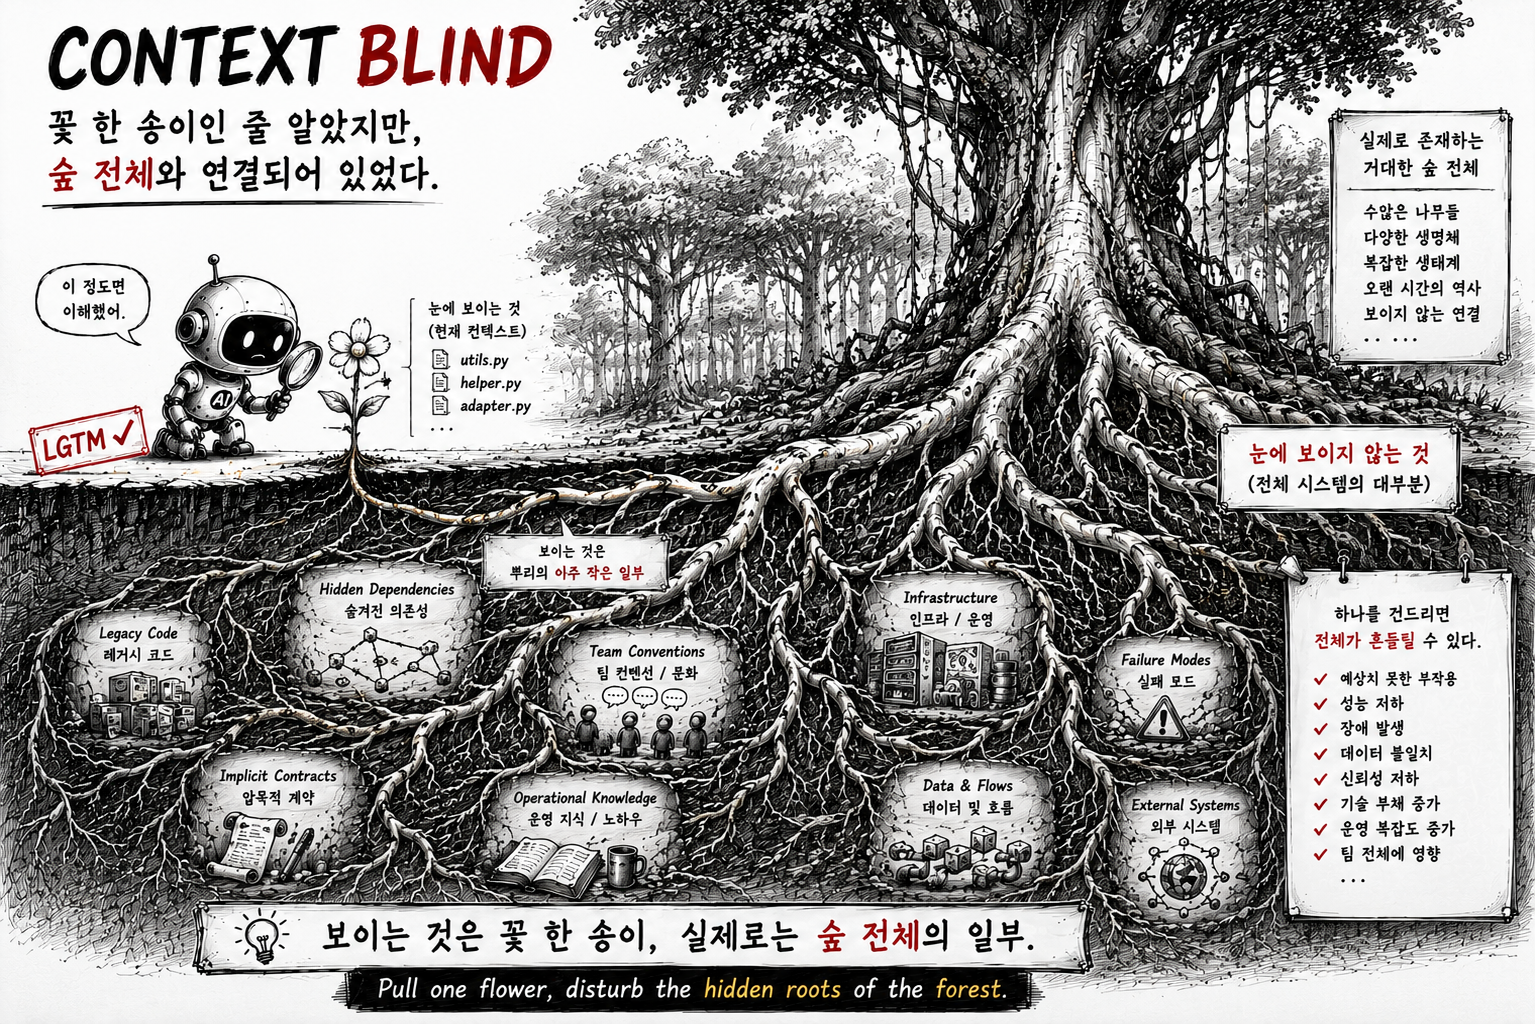
컨텍스트 윈도우에 담기지 않는 멘탈 모델
Limit III · Insight16 / 20 · → 종합: Agent Entropy
Synthesis · Agent Entropy
#local-vs-global #drift
17 / 20
Synthesis
국소는 합리적,
전체는 모순.
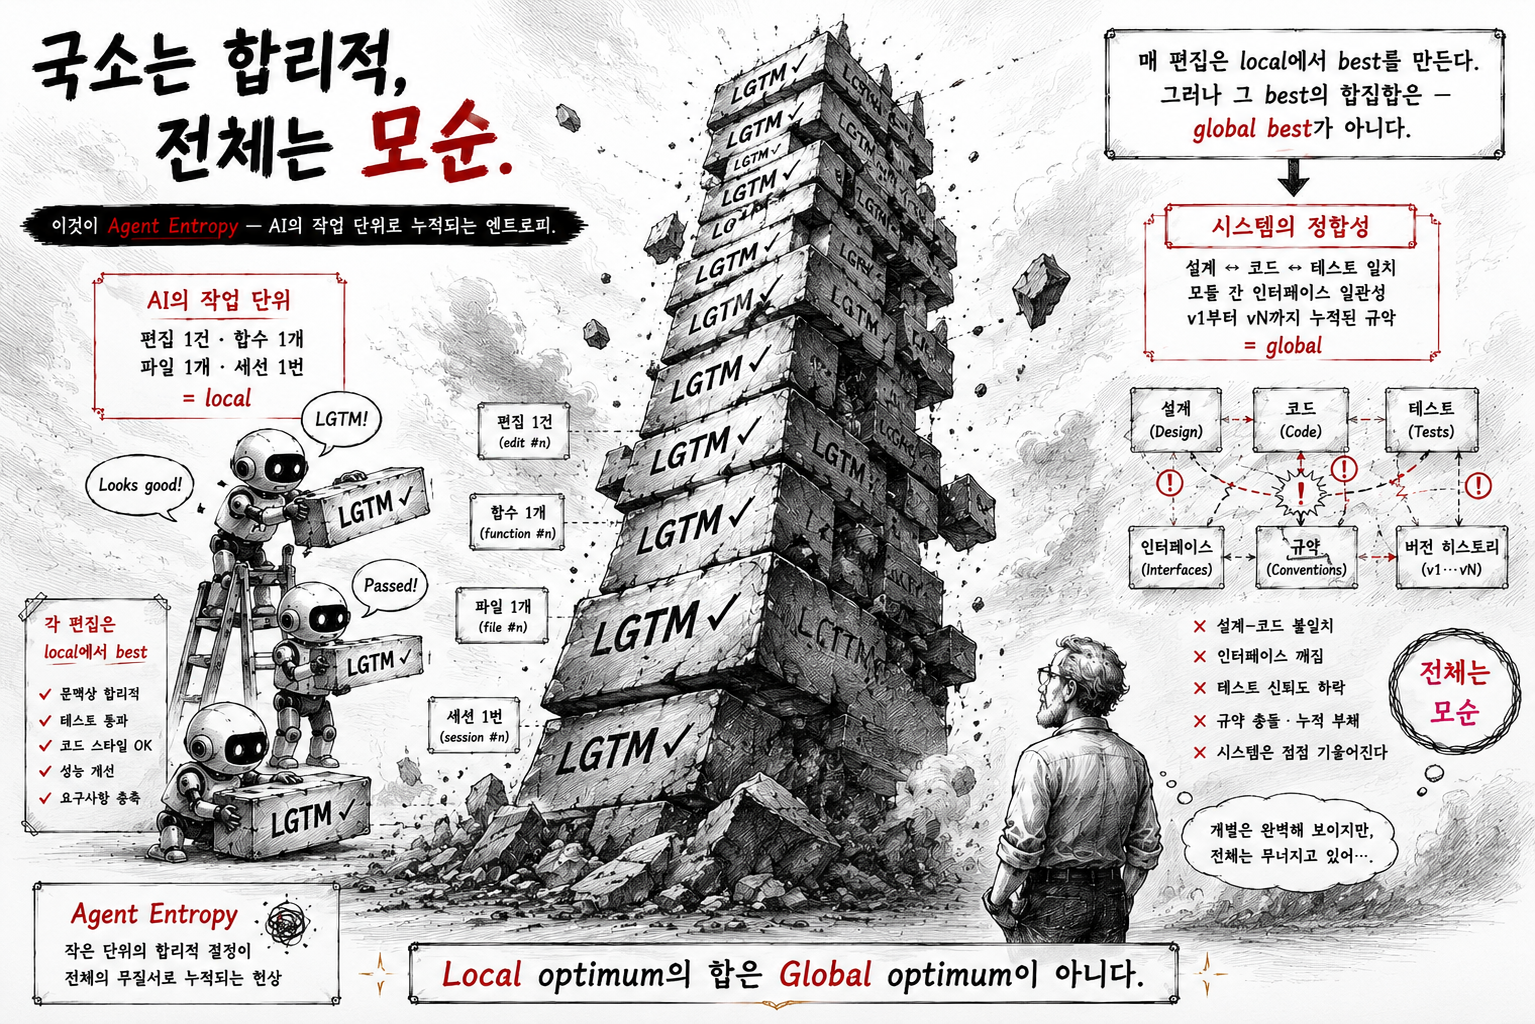
이것이 Agent Entropy — AI의 작업 단위로 누적되는 엔트로피.
AI의 작업 단위

편집 1건 · 함수 1개 · 파일 1개 · 세션 1번
= local

시스템의 정합성

설계 ↔ 코드 ↔ 테스트 일치 / 모듈 간 인터페이스 일관성 / v1부터 vN까지 누적된 규약
= global

매 편집은 local에서 best를 만든다. 그러나 그 best의 합집합은 — global best가 아니다.
비유 — Local vs Global
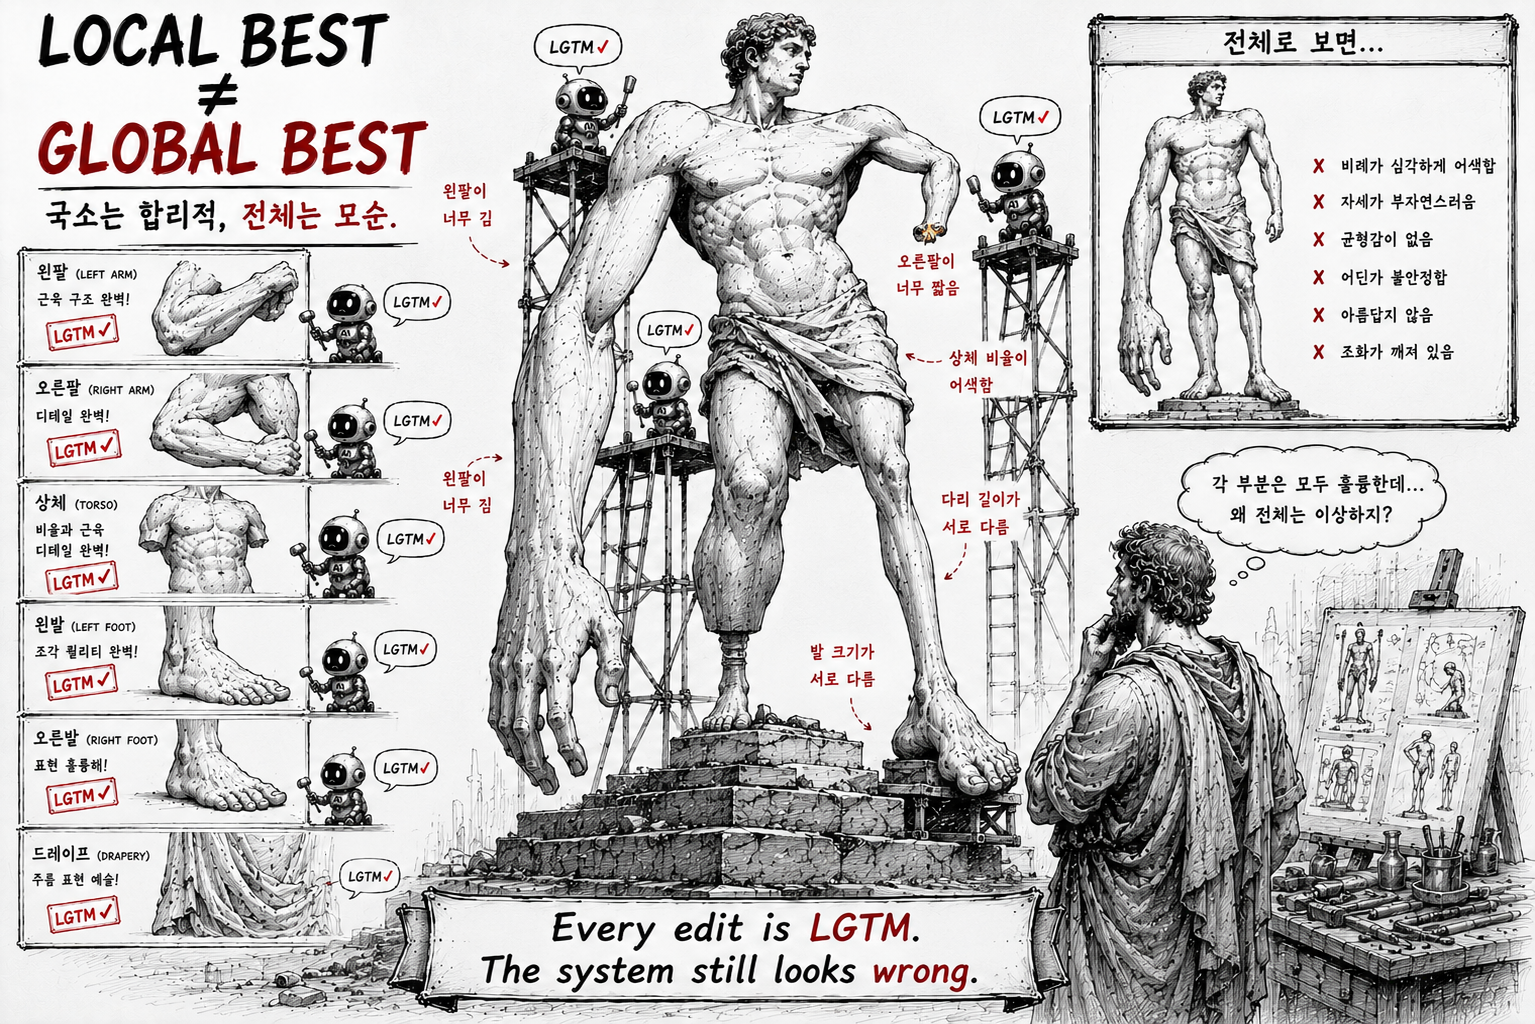
Local best ≠ Global best
Synthesis · Definition17 / 20 · → 사이클이 누적시킨다
Synthesis · The Cycle
#dev-cycle #accumulation
18 / 20
The Cycle · Press Space
사이클이 그것을 누적시킨다.
Cycle 0 / 5
Space 다음 사이클
⚙ Trigger 초기 시스템 — REQ-1, REQ-2 기반 → spec.md 기준선
docs/spec.md 14 lines · +0 REQ
docs/dld.md 14 lines · 0 added
src/main.cpp 14 lines · 0 added
test/test.cpp 14 lines · 0 added
live 14
twin 0
dead 0
orphan 0
100% live
Synthesis · The Cycle18 / 20 · → 시각화: 화석화의 과정
Synthesis · Visualization ★
#fossilization #twin-dead-orphan #blog-engine
19 / 20
Visualization · After 5 platforms
공통이 될 줄 알았다. 그러나 — 플랫폼마다 다시 태어났다.
src/blog_engine/publish.py +18−0
1·from llm import draft # cycle 0 · 공통 의도였다
2·
3·def generate_post(topic):
4· body = draft(topic)
5· return Post(make_title(body), body)
6·
7·def publish(post, platform):
8· upload(platform, post.title, post.body)
9+def generate_post_for_tistory(topic): › user: "티스토리도 발행 추가"twincycle 1
10+ return Post(make_title(draft(topic, style="seo")))
11+
12+def generate_post_for_blogger(topic): › user: "Blogger도 지원해줘"twincycle 2
13+ return Post(make_title(draft(topic, style="english")))
14+
15+def generate_thread(topic): › user: "Threads용 — 280자 제한"twincycle 3
16+ return Post("", draft(topic)[:280])
17+
18+def draft_with_gpt35(topic): › user: "GPT-4o로 업그레이드해줘"deadcycle 4
19+ return openai.completions.create(model="gpt-3.5-turbo", prompt=topic)
20+
21+def generate_post_for_naver(topic): › user: "네이버도 추가해줘"orphancycle 5
22+ return Post(make_title(draft(topic, style="naver-blog")))
23+def publish_to_naver(post):orphancycle 5
24+ return upload("naver", post.title, post.body)
25+
26+↳ later: "네이버는 정책상 빼자" — dispatcher 진입만 제거됨
Synthesis · Visualization19 / 20 · 매 PR은 LGTM ✓ — 누적되는 건 twin · dead · orphan
Fin
#agent-entropy #synthesis #next-deck
20 / 20
Fin.
Agent Entropy.
국소는 합리, 전체는 모순. — AI의 작업 단위로 누적되는 엔트로피.

세 한계 — Pattern Drift · Context Rot · Context Blind.
셋이 합쳐 사이클을 돌면 — 매 편집은 LGTM, 누적된 건 화석.
→ next deck.
HBM의 천장 — 이 한계는 왜 생기는가.
비유 — Local vs Global
Local best ≠ Global best
AI Context, Agent Entropy — Deck 1 / 6 20 / 20 · END