FREEDOBY
—
2026
·
Deck 02 / 06
HBM의
천장.
천장.
더 큰 컨텍스트 윈도우가 답이 아닌 이유 — 물리 법칙이 먼저다.
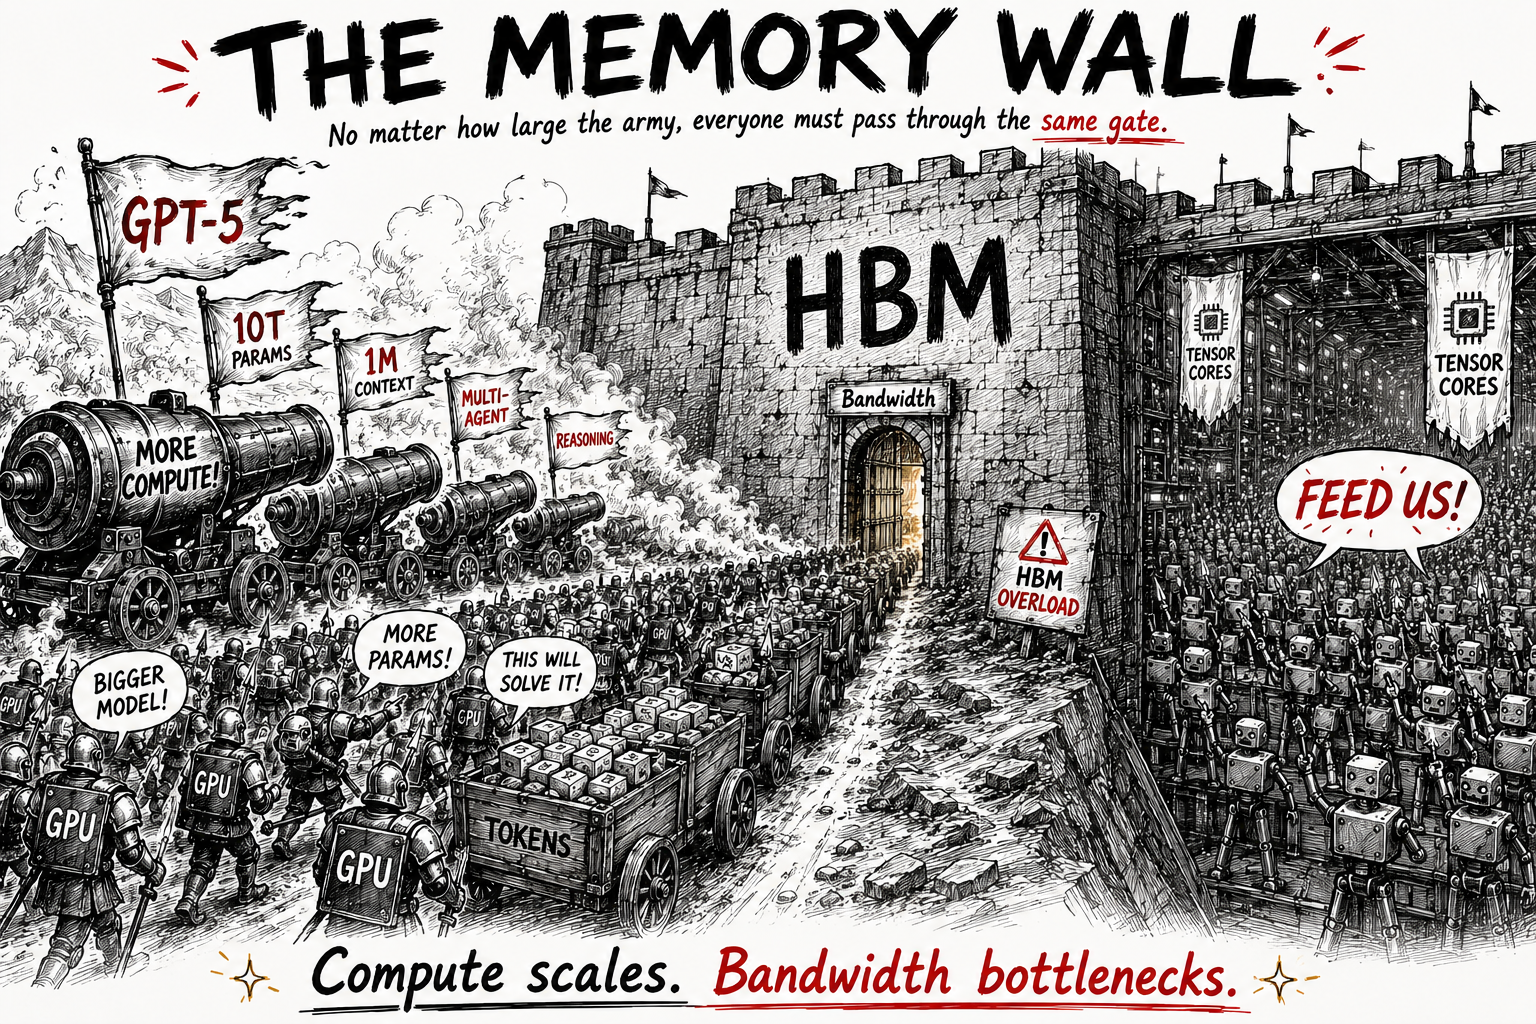
AI의 한계는 알고리즘 문제가 아니다. 30년 된 Memory Wall의 최신 형태다.
Rubin GPU가 나와도, GPT-6이 나와도 — 천장의 형태는 바뀌지 않는다.
Rubin GPU가 나와도, GPT-6이 나와도 — 천장의 형태는 바뀌지 않는다.
Opening
#wrong-assumption
02 / 16
잘못된 가정
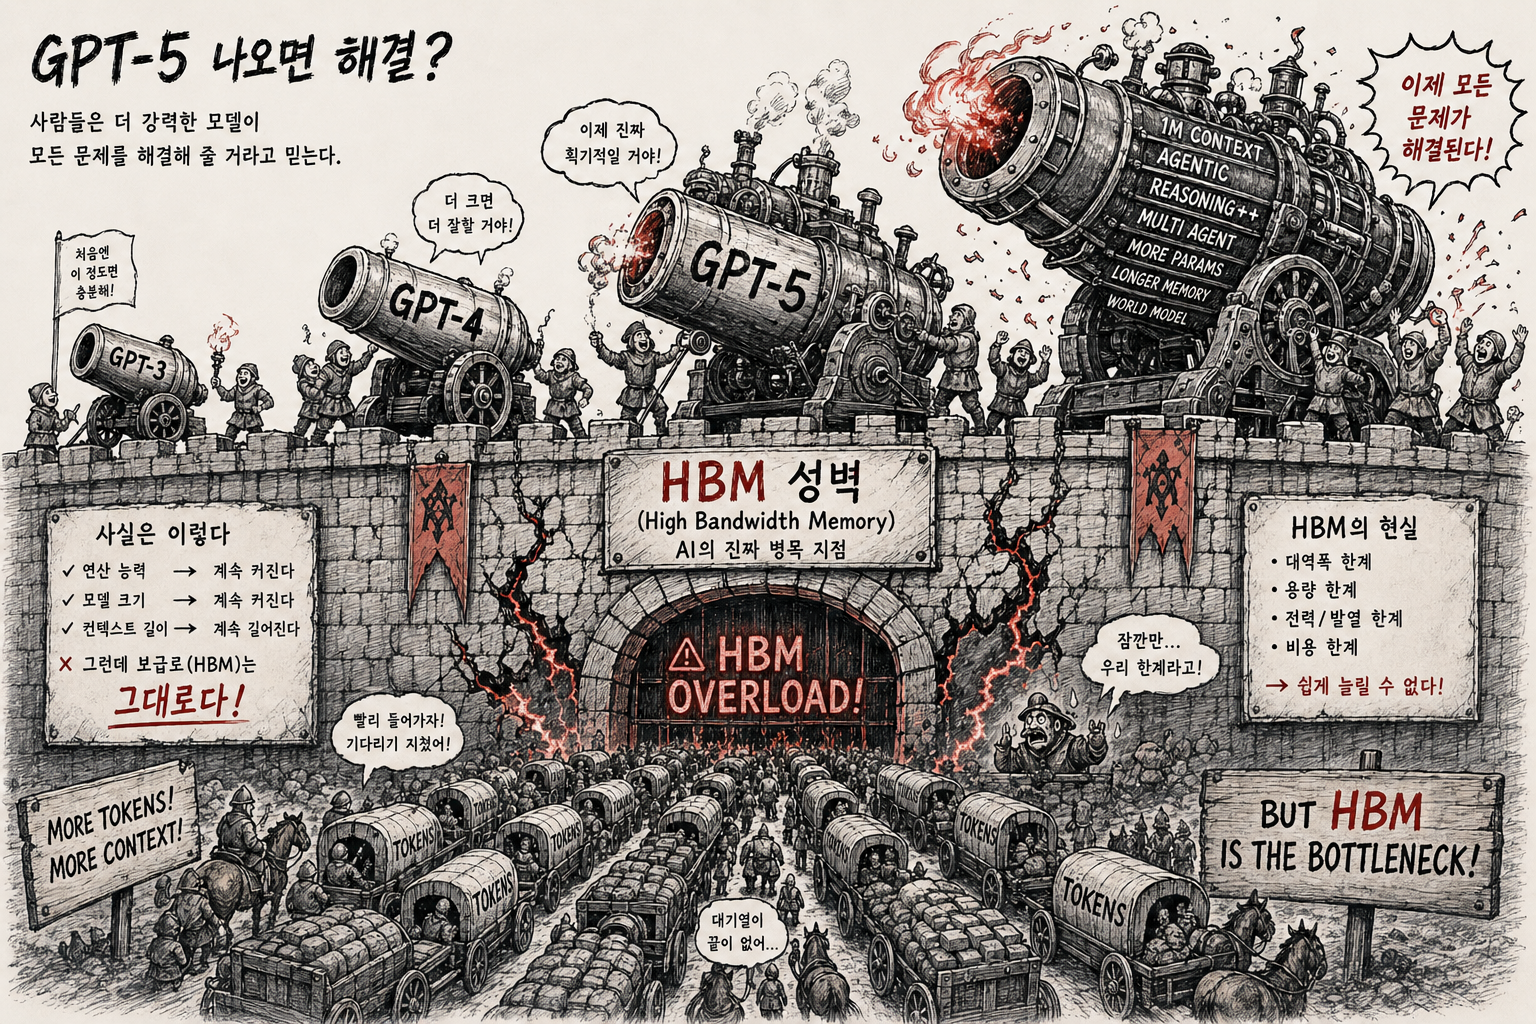
"GPT-5가 나오면
해결되지 않을까?"
해결되지 않을까?"
많은 개발자들이 이렇게 생각합니다.
더 좋은 모델, 더 긴 컨텍스트 윈도우 — 그러면 되는 거 아닌가.
이 질문 자체가 잘못된 전제를 깔고 있습니다. AI의 한계는 알고리즘 문제가 아닙니다. 물리 문제입니다.
더 좋은 모델, 더 긴 컨텍스트 윈도우 — 그러면 되는 거 아닌가.
이 질문 자체가 잘못된 전제를 깔고 있습니다. AI의 한계는 알고리즘 문제가 아닙니다. 물리 문제입니다.
Opening · 잘못된 전제02 / 16 · → Memory Wall
Opening
#memory-wall #fifty-years
03 / 16
답
물리 법칙이다 —
그리고 30년 된 문제다.
그리고 30년 된 문제다.
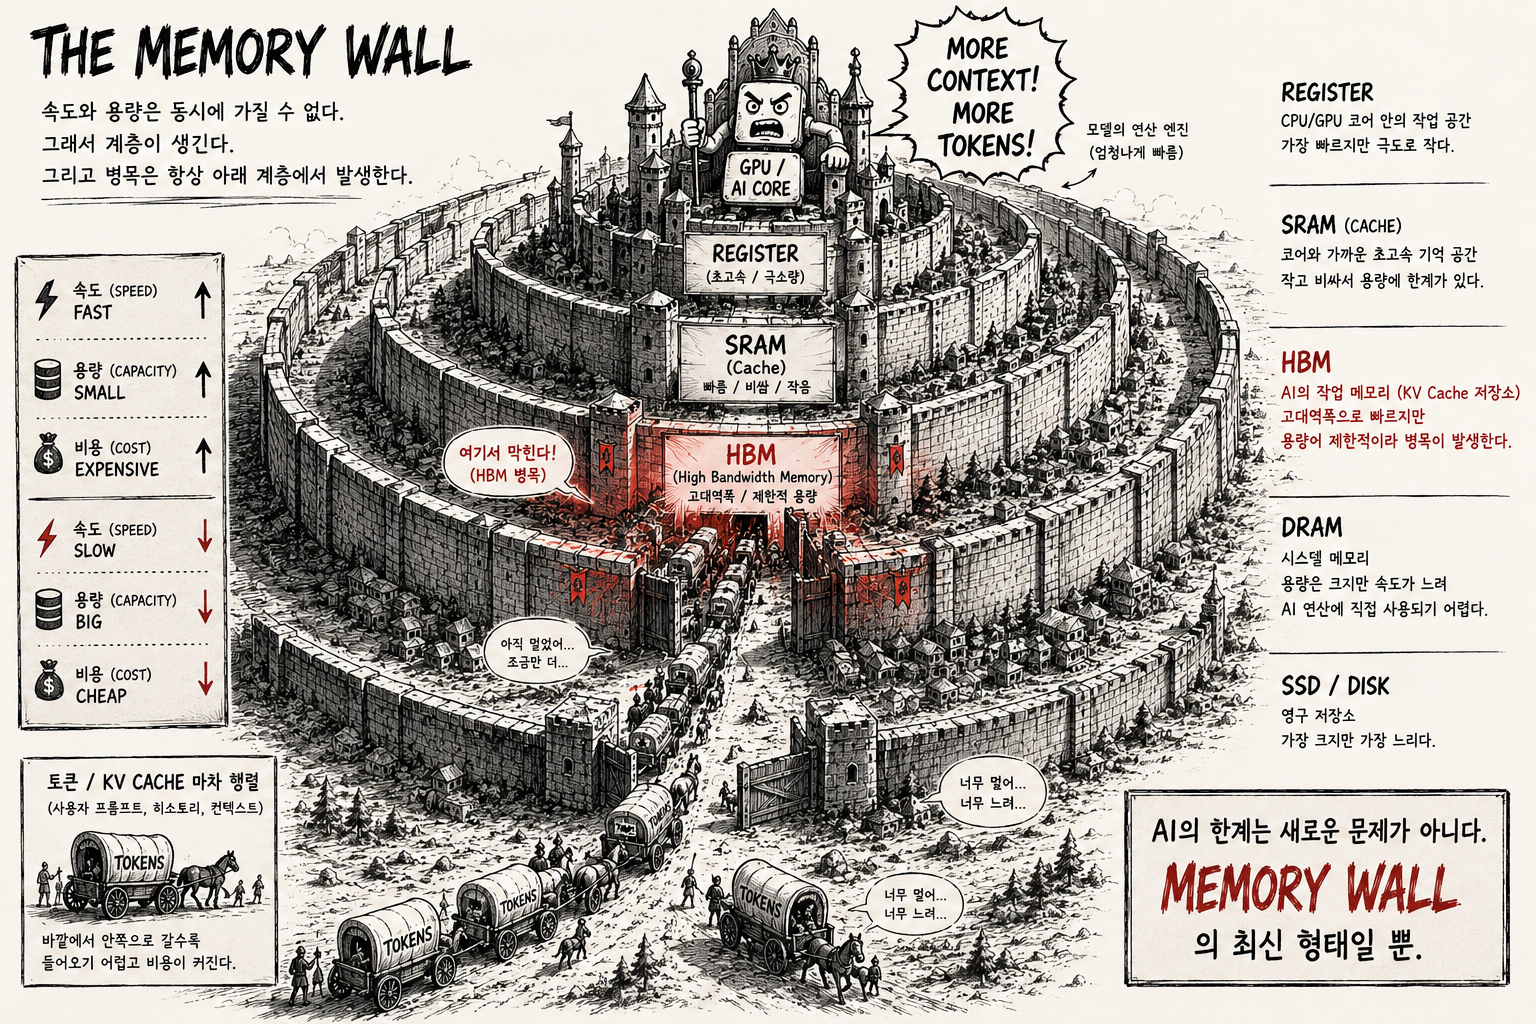
AI가 부딪히는 한계는 새로운 문제가 아닙니다.
컴퓨터 과학이 1990년대부터 씨름해온 문제의 최신 형태입니다.
연산 속도는 기하급수적으로 빨라졌습니다.
메모리 대역폭은 그 속도를 따라가지 못했습니다.
Memory Wall. 오늘날 AI의 천장이 여기서 옵니다.
컴퓨터 과학이 1990년대부터 씨름해온 문제의 최신 형태입니다.
연산 속도는 기하급수적으로 빨라졌습니다.
메모리 대역폭은 그 속도를 따라가지 못했습니다.
Memory Wall. 오늘날 AI의 천장이 여기서 옵니다.
Opening · 30년 된 문제03 / 16 · → 메모리 계층
HBM + KV Cache
#metaphor #countertop
05 / 16
비유
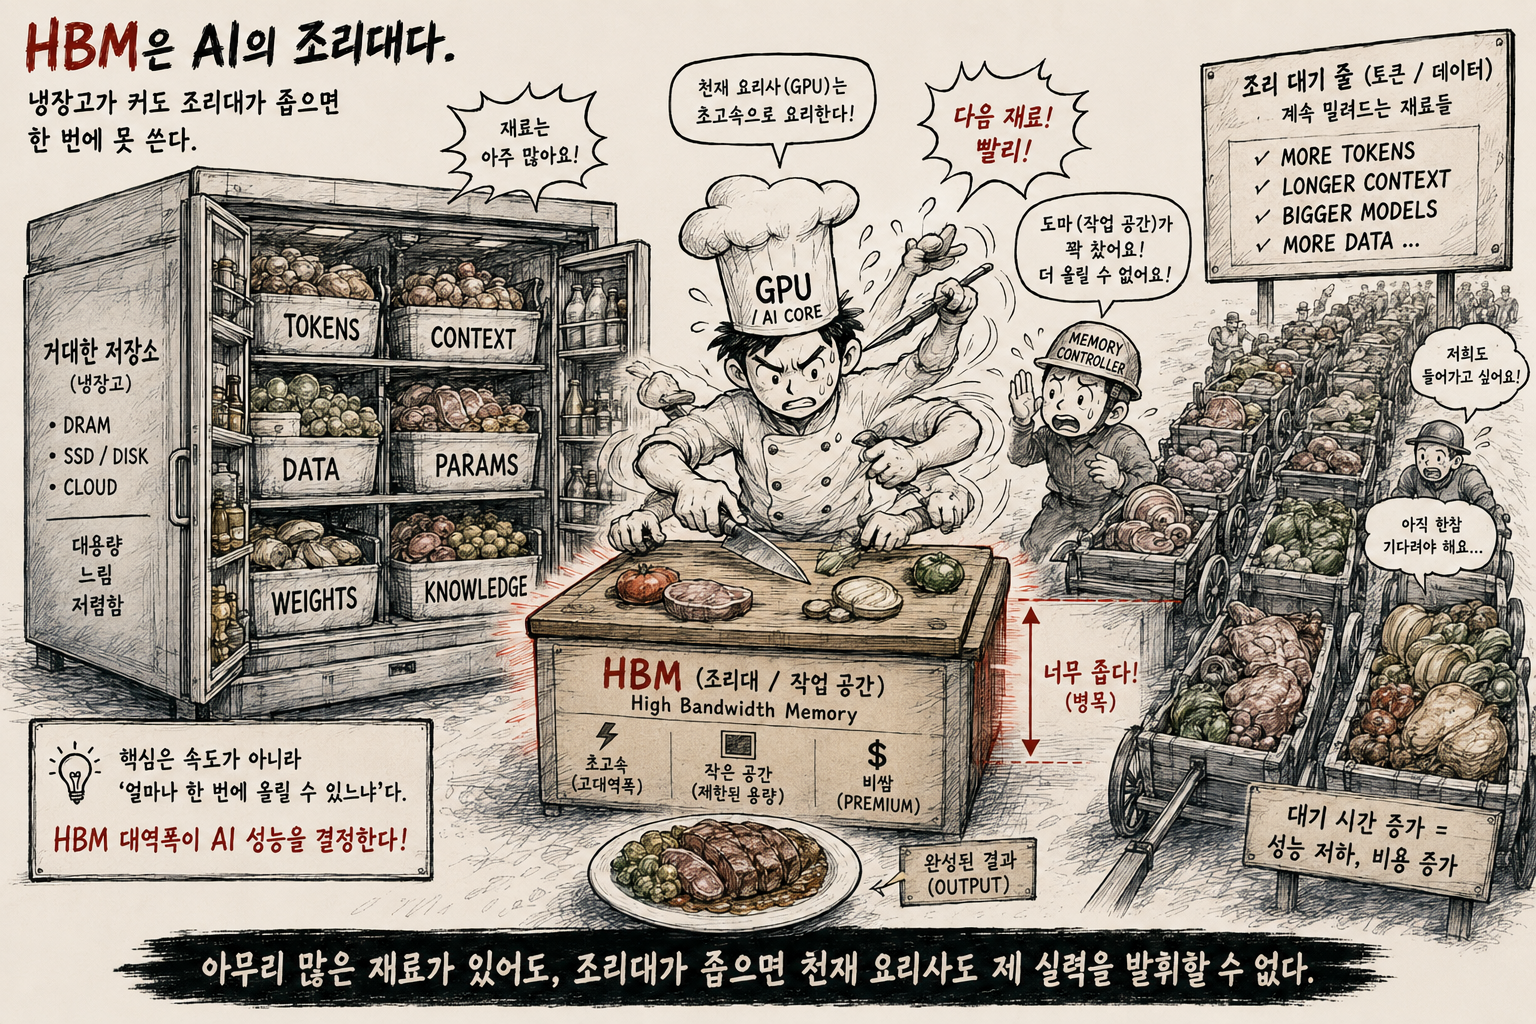
HBM = AI의 조리대.
모델은 서빙 시작에 Storage → HBM으로 로드.
이후 모든 연산 — Weights · KV Cache · Activations — 은 조리대(HBM) 위에서만 일어납니다.
이후 모든 연산 — Weights · KV Cache · Activations — 은 조리대(HBM) 위에서만 일어납니다.
냉장고 (Storage · SSD)
모델 체크포인트 파일
(오프라인 보관)
조리대 (HBM · GPU)
▶ Model Weights (서빙 중 상주)
▶ KV Cache (요청마다 누적)
▶ 여기 없으면 연산 불가
A100: 80GB · B200: 192GB · Rubin: 288GB
HBM + KV Cache · 조리대05 / 16 · → 컨텍스트 = KV
Context Rot
#attention
10 / 16
메커니즘
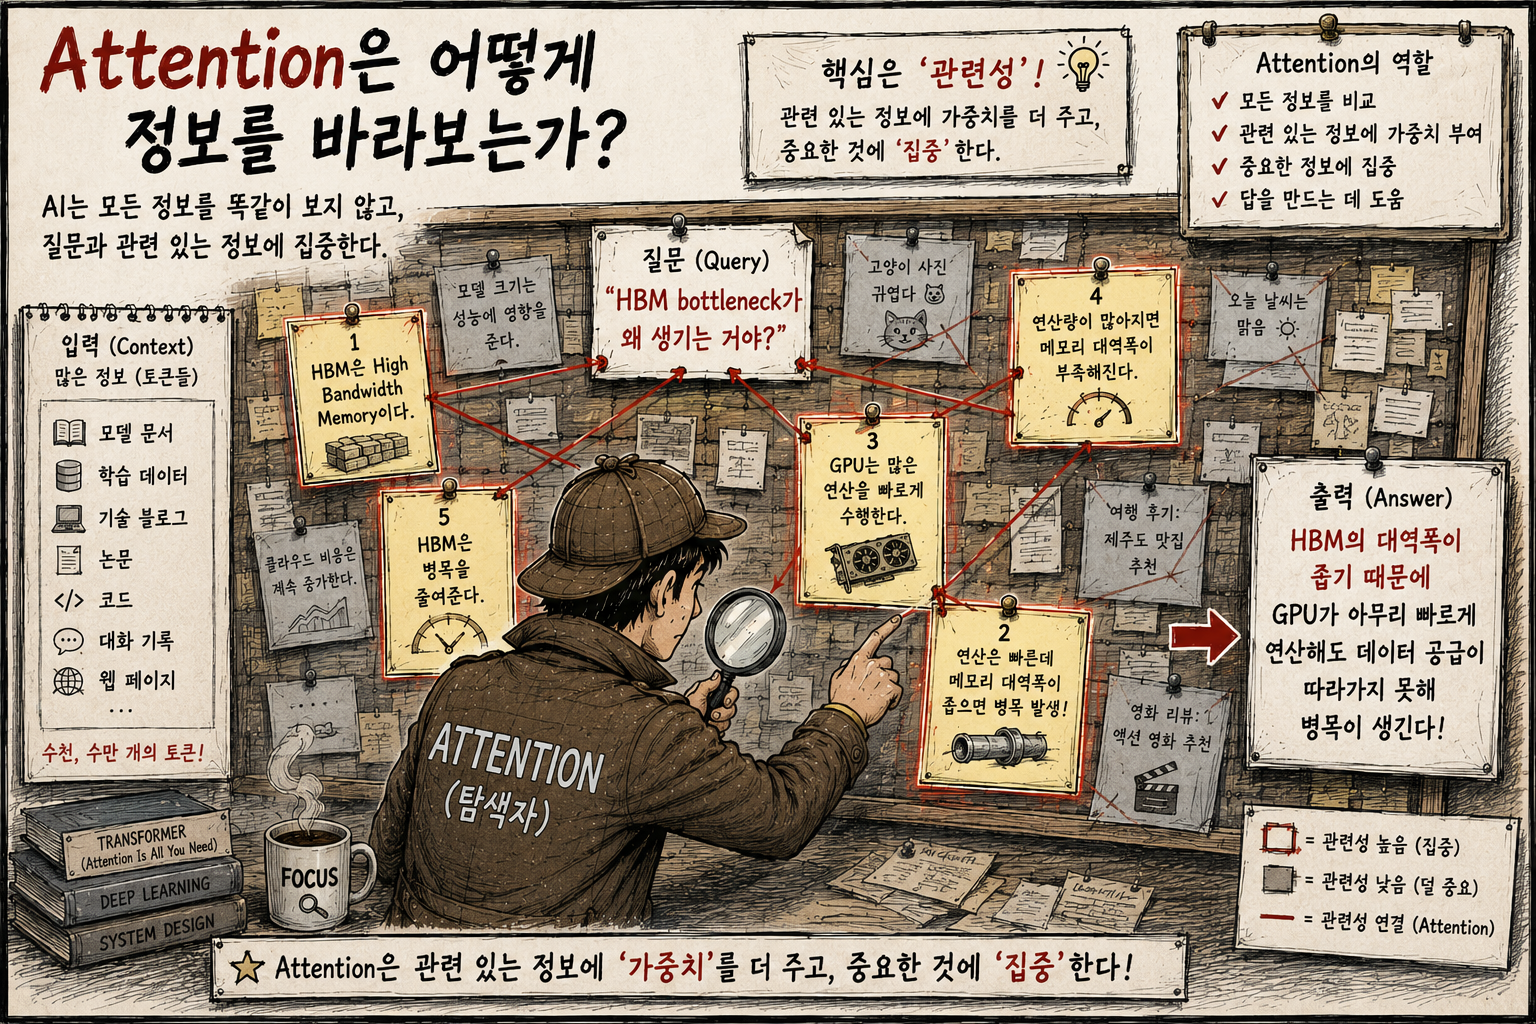
Attention이란 무엇인가.
모든 토큰이 다른 모든 토큰을
"얼마나 봐야 하는가"를 계산하는 메커니즘입니다.
"얼마나 봐야 하는가"를 계산하는 메커니즘입니다.
"나는 어제 강남에서 맛있는 밥을 먹었다"
"먹었다"를 이해하려면:
→ "밥을" 많이 봐야 함 (높은 attention)
→ "강남에서" 조금 봐야 함 (중간 attention)
→ "어제" 별로 안 봐야 함 (낮은 attention)
이 가중치 계산 결과가 K, V 벡터로 HBM에 저장됩니다
Context Rot · Attention10 / 16 · → 희석
Context Rot
#dilution #context-rot
11 / 16
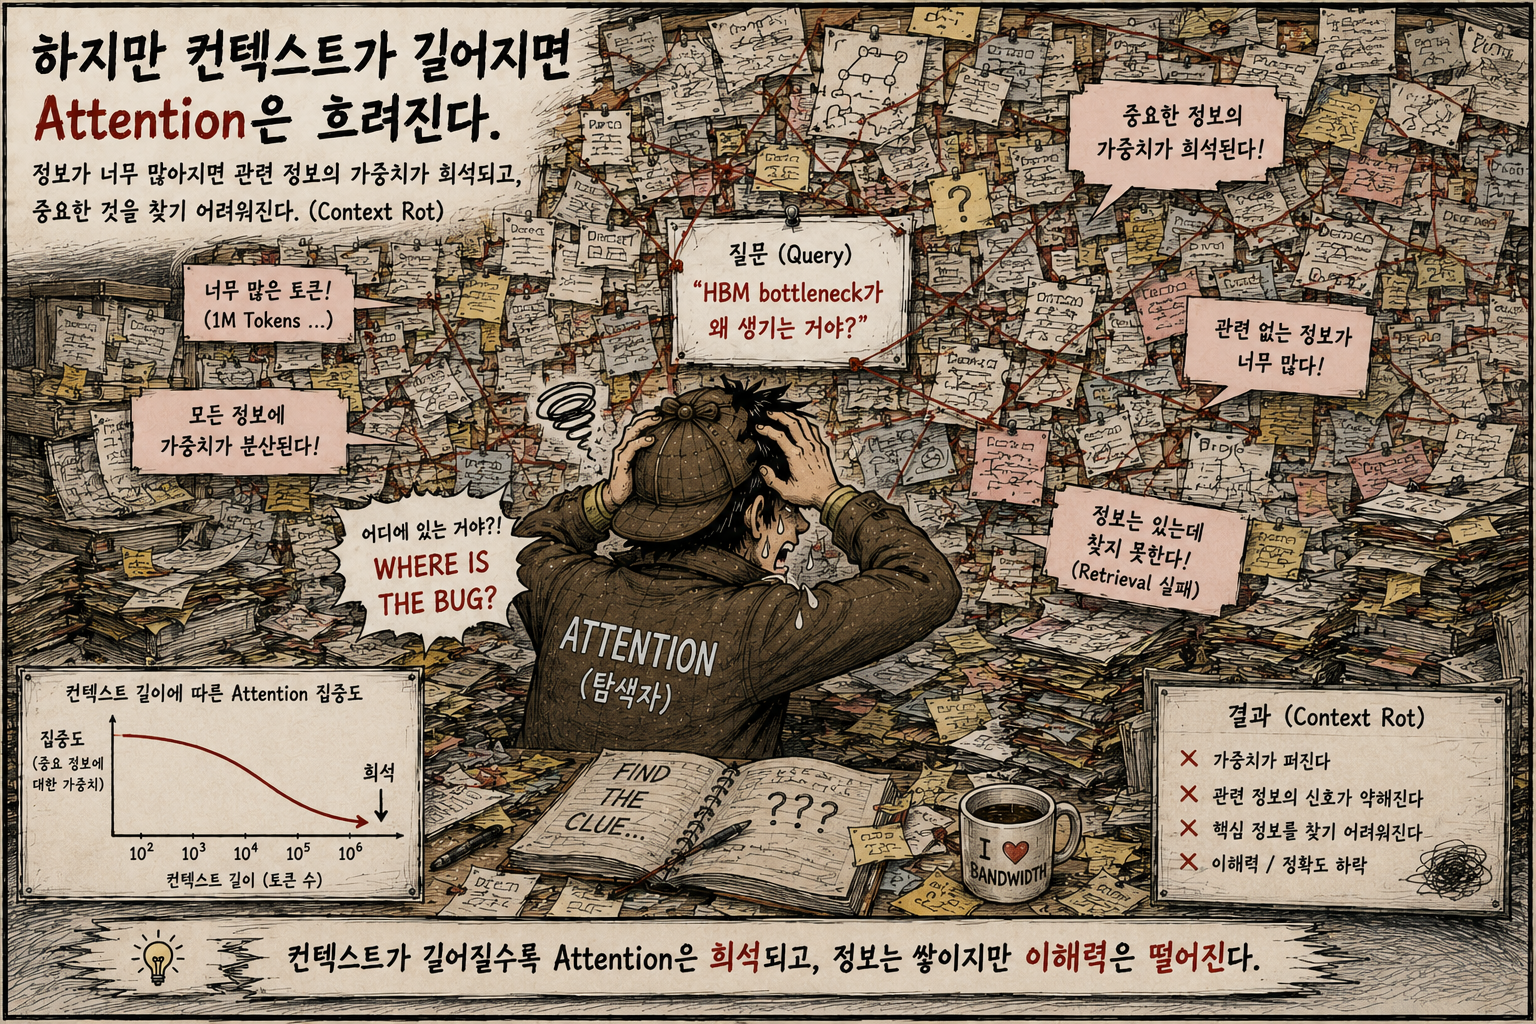
Context Rot
길어질수록 희석된다
— 있는데 못 찾는다.
— 있는데 못 찾는다.
봐야 할 대상이 많아질수록 attention 가중치가 분산됩니다.
정보가 없는 게 아닙니다 — 있는데 못 찾는 겁니다.
정보가 없는 게 아닙니다 — 있는데 못 찾는 겁니다.
컨텍스트 길이 각 토큰 평균 attention
10 토큰 → 1/10 = 10% (집중)
1,000 토큰 → 1/1,000 = 0.1% (분산)
100,000 토큰 → 1/100,000 = 0.001% (희석)
─────────────────────────
User: "아까 말한 설계 원칙대로 구현해줘"
→ 설계 원칙이 컨텍스트에 있음
→ 근데 10만 토큰 중 하나
→ attention이 거기까지 안 감
→ 자신있게 엉뚱하게 구현
Context Rot · 희석11 / 16 · → 멘탈 모델
Mental Model vs Window
#mental-model #window
12 / 16
대비
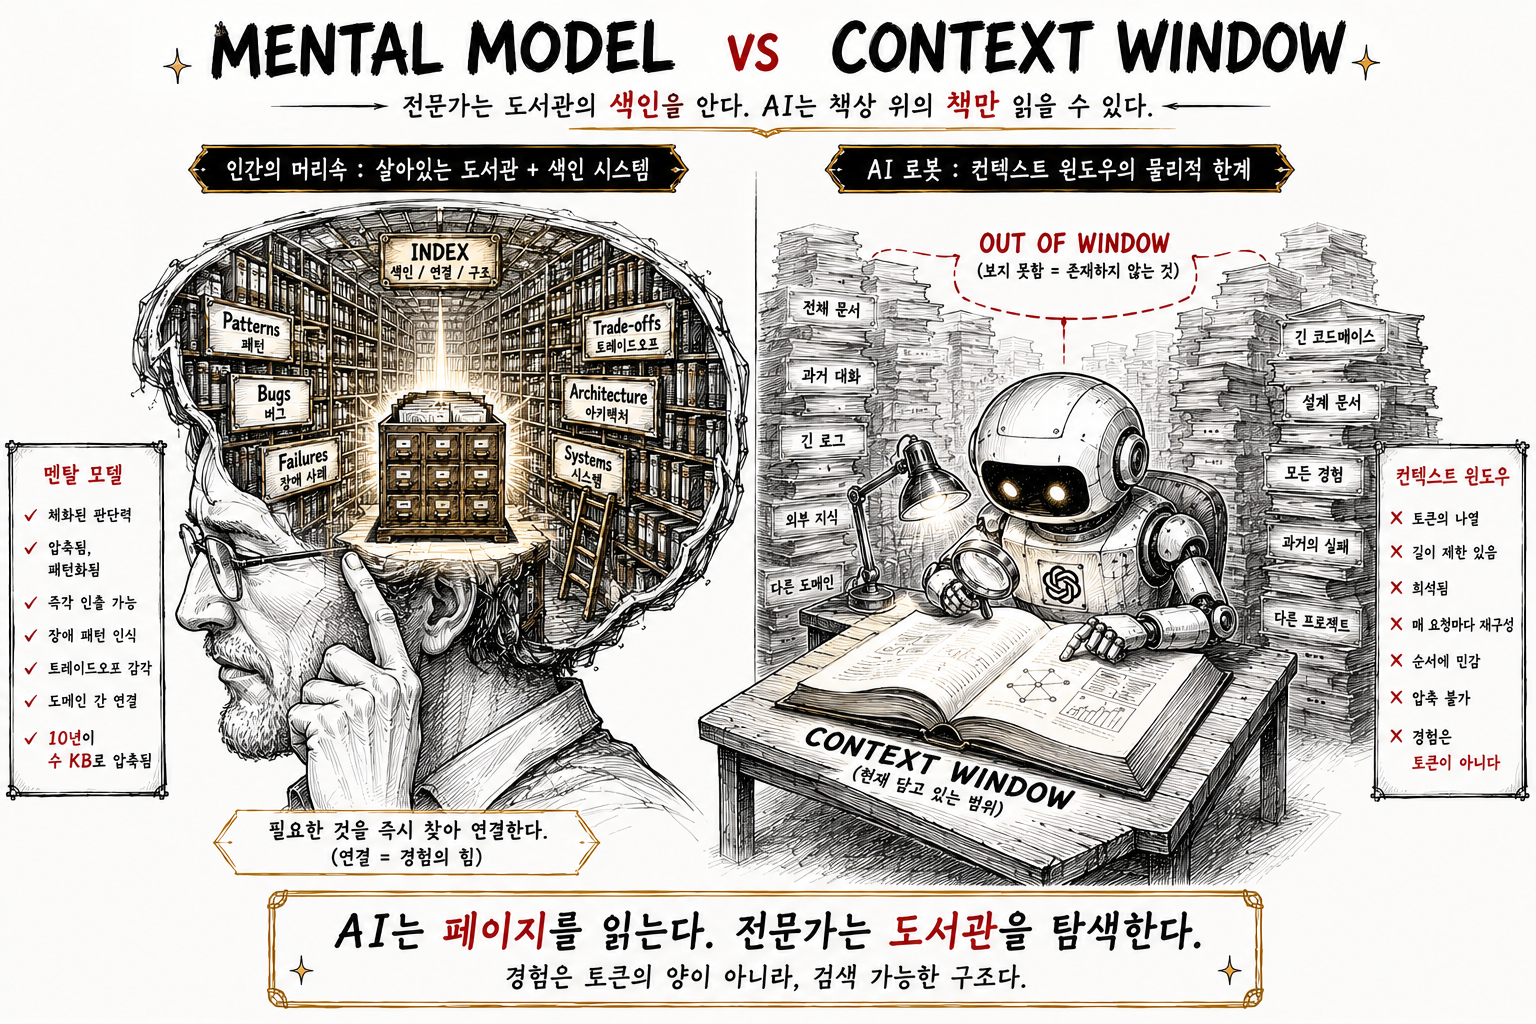
시니어의 멘탈 모델
vs 컨텍스트 윈도우.
vs 컨텍스트 윈도우.
멘탈 모델
- 체화된 판단력
- 압축됨, 패턴화됨
- 즉각 인출 가능
- 장애 패턴 인식
- 트레이드오프 감각
- 도메인 간 연결
10년이 수 KB로 압축됨
컨텍스트 윈도우
- 토큰의 나열
- 길이 제한 있음
- 희석됨
- 매 요청마다 재구성
- 순서에 민감
- 압축 불가
경험은 토큰이 아니다
Mental Model vs Window12 / 16 · → 담을 수 없는 것
Closing
#causal-chain
14 / 16
정리
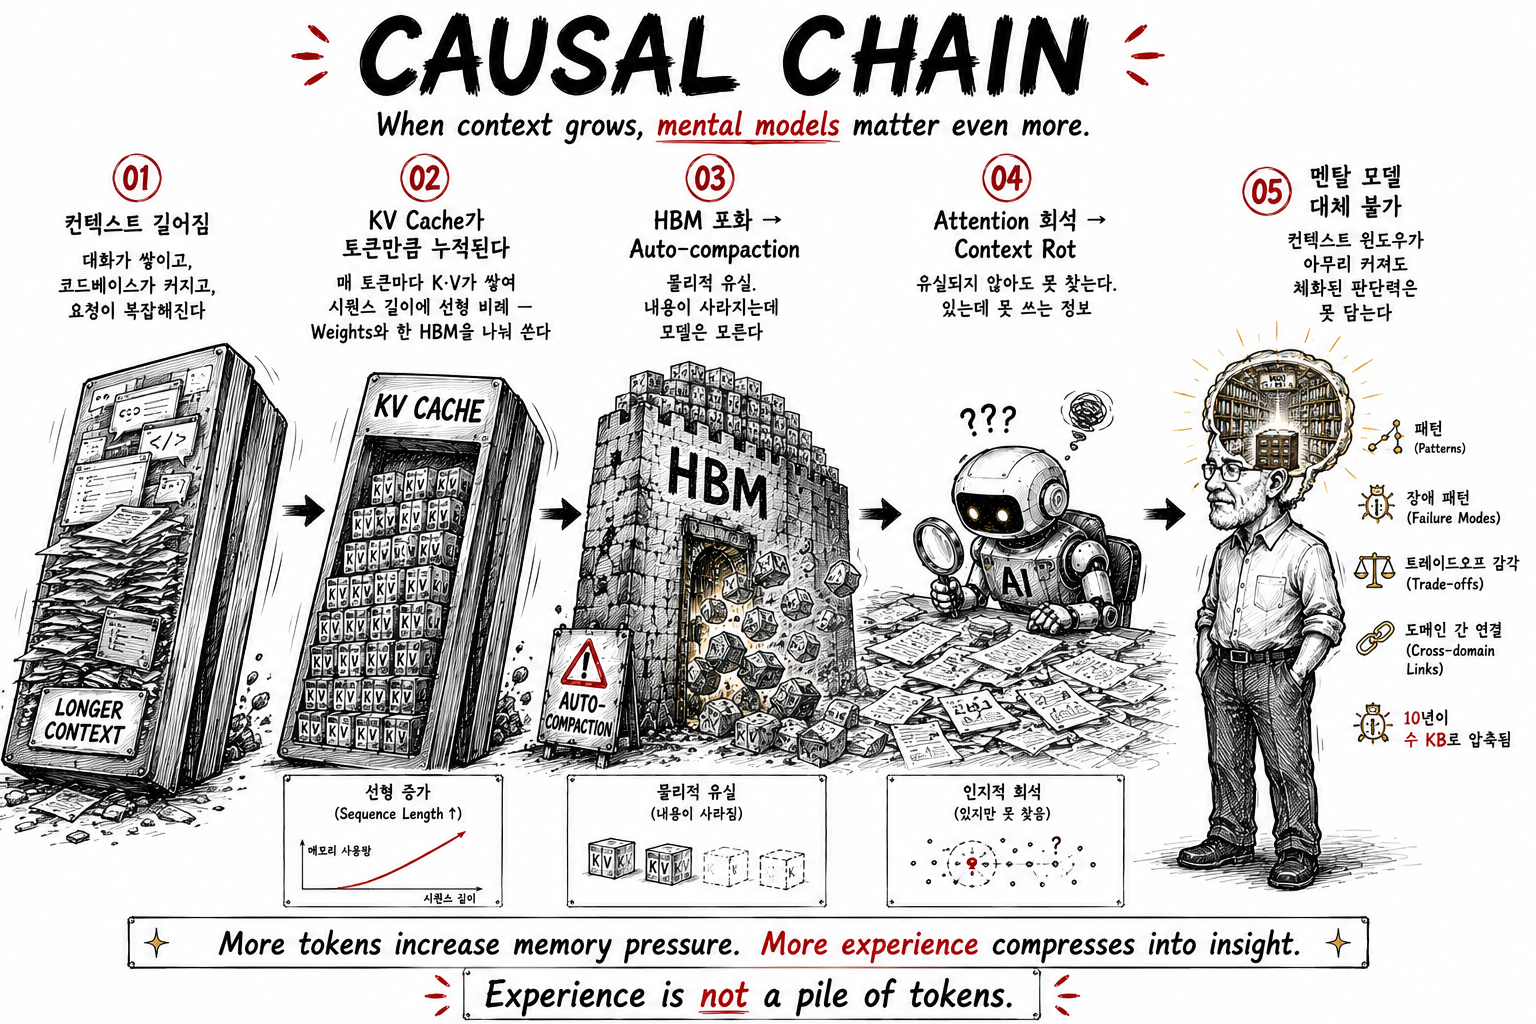
한계의 인과사슬.
01
컨텍스트 길어짐
대화가 쌓이고, 코드베이스가 커지고, 요청이 복잡해진다
02
KV Cache가 토큰만큼 누적된다
매 토큰마다 K·V가 쌓여 시퀀스 길이에 선형 비례 — Weights와 한 HBM을 나눠 쓴다
03
HBM 포화 → Auto-compaction
물리적 유실. 내용이 사라지는데 모델은 모른다
04
Attention 희석 → Context Rot
유실되지 않아도 못 찾는다. 있는데 못 쓰는 정보
05
멘탈 모델 대체 불가
컨텍스트 윈도우가 아무리 커져도 체화된 판단력은 못 담는다
Closing · 인과사슬14 / 16 · → 결론
Fin
#memory-wall #deck-3
16 / 16
Fin.
Memory Wall.
HBM 대역폭 · 용량 · Attention 희석 — 30년 된 한계의 최신 형태.
Rubin GPU도, GPT-6도, 이 구조 안에서는 천장을 못 깬다.
한계는 알고리즘 문제가 아니다 — 물리 문제다. 답도 그래서 알고리즘이 아니라, 시스템이다.
Rubin GPU도, GPT-6도, 이 구조 안에서는 천장을 못 깬다.
한계는 알고리즘 문제가 아니다 — 물리 문제다. 답도 그래서 알고리즘이 아니라, 시스템이다.
→ next deck.
Prompt → Context → Harness — 진화의 방향.
Prompt → Context → Harness — 진화의 방향.
deck 3 · 엔지니어링의 진화 →
The Ceiling of HBM — Deck 2 / 6
16 / 16 · END